
- Интервью
- Отчеты о конференциях
- Цифровая трансформация
- Электронный документооборот
- Финансы: стратегия и тактика
- Закупки и логистика
- Общие центры обслуживания
- Информационные технологии
- Финансовая отчетность
- Риск-менеджмент
- Технологии управления
- Банки и страхование
- Кадровый рынок и управление персоналом
- Управление знаниями
- White Papers
- Финансы и государство
- CFO-прогноз
- Карьера и дети
- CFO Style
- Советы по выступлению на конференциях
- Обзоры деловых книг и журналов
- История финансов
- Свободное время
- Цитаты
КОНФЕРЕНЦИИ
 Все
-
24 сентября 2026 года
Москва -
7 октября 2026 года
Москва -
8-9 октября 2026 года
Москва -
14 октября 2026 года
Москва -
16 октября 2026 года
Москва -
22-23 октября 2026 года
Москва


Артем Ивангородский, «Авито»: Аудит на LLM – как мы перестроили контроль и ушли от выборок
21.09.2026
Подготовка к любому публичному выступлению неизбежно сталкивается с техническими сюрпризами. Слайды для Шестнадцатой конференции «Внутренний контроль и внутренний аудит как инструменты повышения эффективности бизнеса» готовились в том числе с помощью ИИ, и на одном из них закралась ошибка. Я решил оставить её как есть – пусть эта небольшая «галлюцинация» послужит напоминанием о том, что даже зрелые ИИ-решения по-прежнему требуют внимательной проверки человеком.
Но если отбросить шутки, за последние три года наша профессия претерпела трансформацию, сравнимую разве что с переходом от бумажных регистров к автоматизированным системам. И 2026 год стал тем рубежом, после которого старые подходы окончательно утратили эффективность.
От выборочных проверок к тотальному анализу данных
Мой путь в аудите начался 13 лет назад в банковском секторе – QIWI, Ренессанс Кредит. Затем я перешёл в e-commerce, где мы впервые стали применять data-driven методики, проверяя не выборки, а весь массив операций. В «Авито» я пришёл три года назад с задачей выстроить операционный аудит с нуля, а позже принял на себя и ИТ-периметр. Сегодня я также занимаюсь внедрением новых инструментов, не отрываясь от операционной работы.
Ещё пять лет назад, во время подготовки к сертификации внутреннего аудитора, нас учили строить репрезентативные выборки из 15–25 операций и экстраполировать выводы на всю генеральную совокупность. Это считалось стандартом. Однако уже тогда рынок предъявлял иные требования: аудитор должен был уметь работать с массивами данных, владеть SQL и Python, проверять миллионы транзакций. Тем не менее существовали жёсткие ограничения.
Мы имели дело только с машиночитаемыми данными – логами и транзакциями, а логику проверок зашивали в код в виде фиксированных правил. Это позволяло отлавливать лишь те отклонения, которые мы заранее предусмотрели. Если из миллиона операций выявлялось десять тысяч аномалий, аудитор всё равно был вынужден выбирать из них «типичные» для итогового заключения. Такой подход был не только трудоёмким, но и методологически уязвимым.
Почему именно 2026 год стал поворотным
Главный катализатор изменений – большие языковые модели (LLM). Они сняли два фундаментальных ограничения нашей профессии: выборку и периодичность.
Выборка всегда была не методологическим выбором, а вынужденным компромиссом с экономикой ресурсов. Мы не могли позволить себе проверять всё из-за нехватки времени и сотрудников. Периодичность – та же история: риск не привязан к календарным кварталам, а мы часто приходили с отчётом о событиях, которые произошли полгода назад.
В 2023 году мы экспериментировали с GPT-3.5, получали забавные, но несерьёзные результаты и быстро закрывали эту тему. Сейчас качество моделей выросло экспоненциально. Например, бенчмарк GPQA Diamond включает 198 вопросов уровня докторов наук, ответы на которые невозможно найти через поисковые системы. В 2023 году GPT-4 давала лишь 39% правильных ответов, тогда как специалисты с учёной степенью показывают 65%. Фронтир-модели 2026 года от Anthropic и OpenAI достигают 94%, а новая Claude Mythos (пока в ограниченном доступе) – 94,5%.
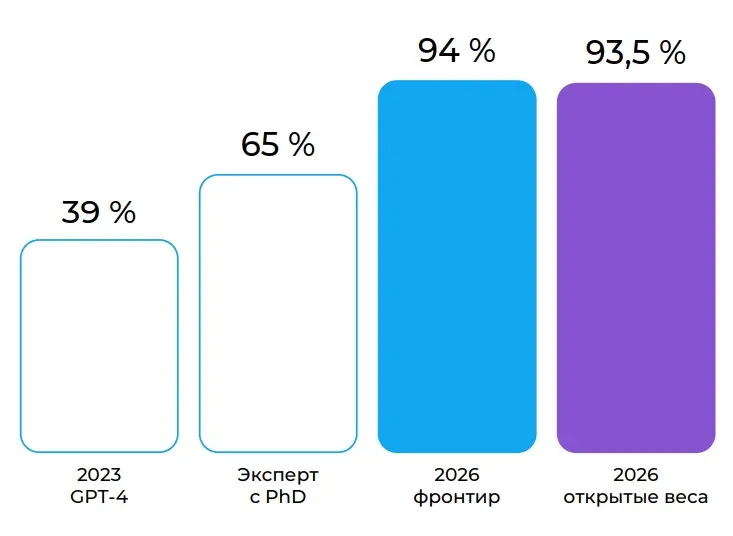
Ключевой момент: сегодня выбор между качеством модели и контролем над данными больше не стоит. Китайские открытые модели, такие как Kimi K3, почти догнали лидеров. Мы можем развернуть их внутри защищённого контура и работать с персональными и коммерческими данными, не передавая их за периметр.
Смена парадигмы: от ретроспективы к сигналу в реальном времени
Ретроспективный аудит, фиксирующий уже случившиеся потери, теряет свою ценность для коммерческой компании. Аудиторам, которые приносят результаты постфактум, всё сложнее обосновать необходимость своей функции. Задача аудиторов сегодня – встраиваться в процессы и помогать предотвращать потери на ранних стадиях.
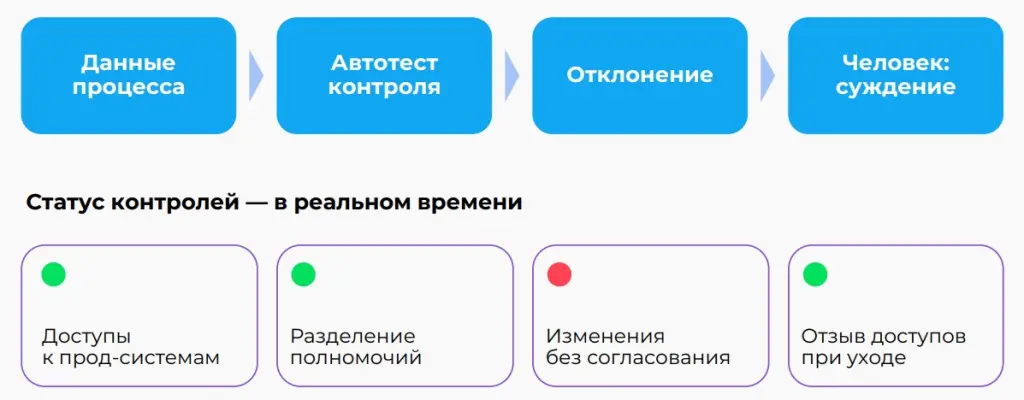
Внутренний аудит должен отказаться от жёсткого годового плана проверок и превратиться в «контрольную вышку», которая непрерывно отслеживает состояние системы. Для этого аудиторам нужно внедрять онлайн-мониторинг контролей, но не подменять собой первую и вторую линии, а оставаться третьей линией, которая независимо подтверждает корректность процессов.
Ежеквартальной проверки доступов к продуктивным системам, разделения полномочий и отзыва прав при увольнении сотрудников уже недостаточно: эти данные должны поступать аудиторам в реальном времени. Следующий шаг – подключить к сигналам об отклонениях ИИ-агента, который самостоятельно направляет ответственному сотруднику уведомление о выявленных избыточных правах и отслеживает статус устранения нарушения.
Сплошное тестирование и работа с неструктурированными данными
Ранее data-driven подход фактически игнорировал текстовые документы – договоры, акты, переписку. Мы делали вид, что их просто не существует. Теперь же мы имеем возможность анализировать полный массив неструктурированной информации.
Показательный пример – закупочный процесс. В крупной коммерческой компании это тысячи, а то и десятки тысяч договоров. Раньше прочитать их все было невозможно: аудитор ограничивался небольшой выборкой, а остальные документы оставались непроверенными. Сегодня LLM обрабатывает весь массив за короткий срок: полтора-два дня. Достаточно простого критерия – сверить сроки оплаты, указанные в договоре, с данными учётной системы, – чтобы выявить отклонения, которые при выборочной проверке почти наверняка остались бы незамеченными.
При этом роль человека остаётся критически важной. Окончательные решения по существу нарушений принимает аудитор. ИИ готовит фактуру, предлагает варианты, но суждение и ответственность за вывод лежат на человеке. Доказательства должны быть воспроизводимыми, как того требуют профессиональные стандарты.
Промпт как новый язык программирования контроля
Качество ответа модели напрямую зависит от промпта. По сути, промпт – это программа проверки, написанная на естественном языке, и формулировать его нужно так же строго, как код. В нём определяются объект и источник данных, критерии успешного выполнения контроля, признаки отклонения и порядок действий при неопределённости. Отдельно фиксируются формат вывода и требования к аудиторскому следу.
Но даже тщательно написанный промпт нельзя сразу запускать в работу. Его необходимо протестировать на реальных данных: с опечатками, пропусками, нестандартными формулировками и разными версиями документов. Промпт, который безупречно работает на нескольких чистых примерах, на полном массиве почти наверняка даст ложные срабатывания и пропуски. Модели могут ошибаться с высокой уверенностью, поэтому реальную точность проверки показывает только тестирование, а не самооценка модели.
Для интеграции различных источников – почты, тикетов, баз данных и файловых хранилищ – мы используем открытый инструмент n8n. Он позволяет собирать данные и передавать их в локальную модель. Процесс разработки прототипов мы также автоматизировали: мы поручаем Claude собрать готовый пайплайн в n8n, и в течение часа получаем работающее решение.
Сам ИИ как объект контроля
Технологии принесли не только возможности, но и целый спектр новых рисков, которые ранее отсутствовали в наших матрицах.
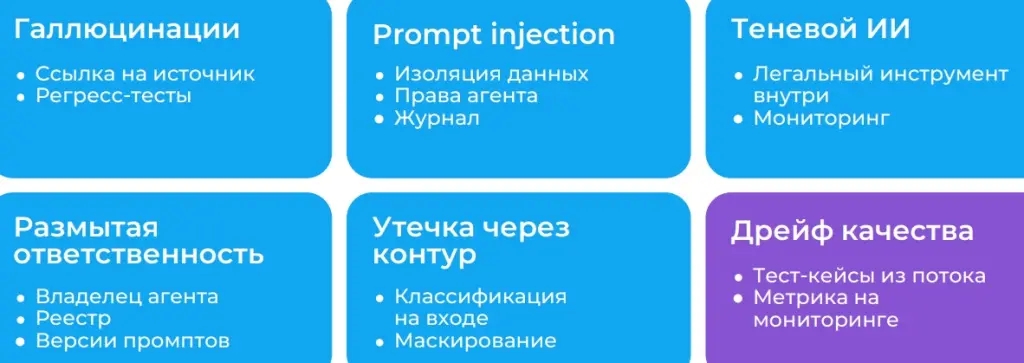
- Галлюцинации. Модель оперирует статистическими закономерностями, и при недостатке контекста она может додумывать факты. Противодействие – обязательное указание источников и проведение регрессионных тестов на живых данных.
- Промпт-инъекции. Недавно я столкнулся с реальным случаем: в документ невидимым текстом была встроена инструкция, которую модель восприняла как приоритетную команду. Это возможно, потому что модель не всегда надёжно отличает данные от инструкций. Решение – фильтрация входящих данных и строгое ограничение прав агента.
- Теневой ИИ. Если внутренний корпоративный инструмент неудобен, сотрудники начинают использовать внешние подписки, загружая туда данные, которые нельзя выносить за периметр. Единственный способ борьбы – сделать легальный инструмент более функциональным и простым, чем внешние аналоги.
- Размытая ответственность. Когда агент, созданный одним сотрудником, продолжает работать после его ухода, а новый владелец не понимает логику, возникает вопрос: кто отвечает за ошибки? За каждым агентом должен быть закреплён владелец, который понимает его логику и отвечает за результат.
- Утечка через контур. Любое попадание файла в контекст внешней модели фактически является передачей данных. Даже если использование данных для обучения отключено, риск остаётся. Для чувствительных данных нужно использовать только внутренние модели.
- Дрейф качества. Инструмент, точный сегодня, может потерять эффективность завтра из-за изменения структуры данных или появления новых сценариев. Необходимо тестирование на реальных, зашумлённых кейсах и постоянный мониторинг метрик качества.
Практические шаги для старта
Если ваша компания пока избегает внедрения ИИ в контрольные процедуры, рекомендую начать с одного машиночитаемого контроля, где уже есть фиксированные логи. Определите чёткие критерии проверки, напишите промпт, с помощью n8n передайте в LLM реальные данные для тестирования. Оцените результаты, настройте инструмент и только затем выводите его в продуктивную среду.
Даже один успешный кейс позволит менеджменту увидеть конкретный эффект: либо вы обнаружите аномалии, которые ранее оставались незамеченными, либо получите объективное подтверждение, что отклонений нет, без оговорок о возможной ошибке выборки. И крайне важно сразу добавить в карту рисков новые позиции, связанные с использованием ИИ, и назначить за них ответственных владельцев.
Экономический аспект: аренда или покупка GPU
Если вы задумываетесь о развёртывании собственной инфраструктуры, приведу ориентировочные расчёты для конфигурации из двух видеокарт по 80 ГБ, достаточной для модели с 30–70 млрд параметров.
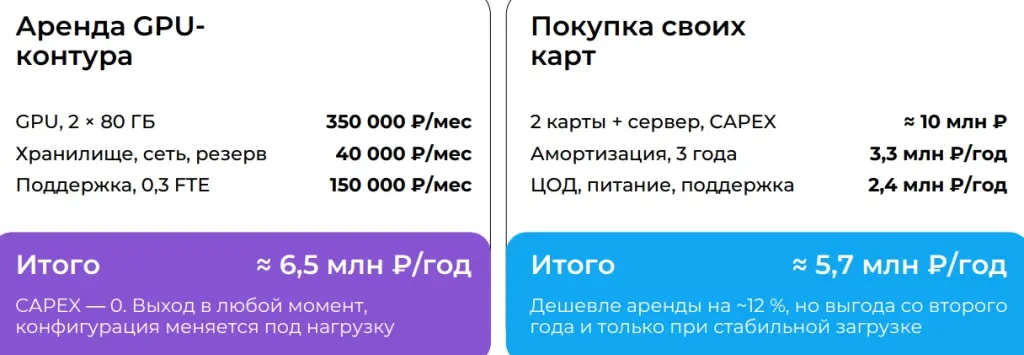
При аренде GPU-контура затраты составляют около 350 тыс. рублей в месяц на само оборудование, плюс хранилище, сеть и поддержка (0,3 FTE). Итоговая годовая сумма приближается к 6,5 млн рублей.
При покупке собственных карт капитальные вложения составят порядка 10 млн рублей. С учётом амортизации за три года (3,3 млн в год) и расходов на ЦОД и электроэнергию годовой бюджет оценивается в 5,7 млн рублей. Покупка оказывается дешевле аренды примерно на 12% в перспективе нескольких лет и только при условии стабильной загрузки оборудования не менее чем на 80%. В противном случае экономия превращается в убыток.
Мы живём в период стремительных изменений, и я рад, что моя карьера пришлась на этот переломный момент. Если у вас возникнут вопросы по внедрению описанных подходов или выбору архитектуры – я всегда открыт для обсуждения.
Артем Ивангородский, руководитель операционного и ИТ-аудита, «Авито»
Наши конференции:
- Конференция «Операционная эффективность»
- Девятая конференция «Цифровизация промышленности»
- Конференция «Финансовая устойчивость девелопера: управление ликвидностью, проектным финансированием и продажами в условиях сжатия рынка»
- Восемнадцатый форум финансовых директоров розничного бизнеса Retail CFO 2026
- Двадцать вторая конференция «Цифровизация корпоративных бизнес-процессов»
- Пятнадцатая конференция «Цифровизация фармбизнеса»
- Пятнадцатый форум финансовых директоров фармацевтического бизнеса Pharma CFO 2026
- Четвертая конференция «Цифровизация финансового рынка в России: тренды и перспективы развития»
- Одиннадцатая конференция «Информационные технологии в бюджетировании»
- Четырнадцатый Форум финансовых директоров строительной отрасли